
奥尼译桥
应用介绍
部署方式
部署方式
Docker 部署
镜像已适配奥尼设备(NVIDIA Jetson / Thor,aarch64 / sm_110 架构): translate-backend:aoni-docker-cn-guangzhou.cr.volces.com/public/app/translate-backend:v1.0.0(FastAPI 后端:VAD 断句 / 音频编排 / 翻译调度 / 历史与知识库 SQLite) translate-frontend:aoni-docker-cn-guangzhou.cr.volces.com/public/app/translate-frontend:v1.0.0(前端:nginx 静态页 + WebSocket 反代,纯 HTTP) ASR/翻译模型:aoni-docker-cn-guangzhou.cr.volces.com/public/llm/trt-inference:0.10.0-jp7.2-tos-tc(TRT Edge-LLM:Qwen3-ASR-1.7B 识别 + Hy-MT2-7B 翻译;首启自动从 TOS 下载引擎约 13GB,重启仅校验跳过) 通过 docker compose up -d 一键拉起(仓库根 docker-compose.yml,或 AI Hub 部署包 translate-v1.0.0/deploy.yml)。 对外端口:8101(前端,可参数化 {port});模型服务走 host 网络 31802 / 31803。 数据持久化:历史对话 ./data/history.db;录音片段(诊断)./segments/。 部署前提:1. 同型号 Jetson 硬件(TRT 引擎与 SoC/JetPack 强绑定);2. NVIDIA 驱动 + nvidia-container-toolkit;3. 宿主机 PulseAudio 标准布局并连接麦克风($XDG_RUNTIME_DIR/pulse) 4. 内存:稳态占用约 54GB(翻译模型约 49GB + 识别模型约 5GB),建议预留 ≥64GB,勿与其它大模型服务同跑 (如镜像拷贝到不连通外网的服务器,可直接解压 yml 后用 docker 拉起)
注意该项目需要jetpack>=7.2
使用说明
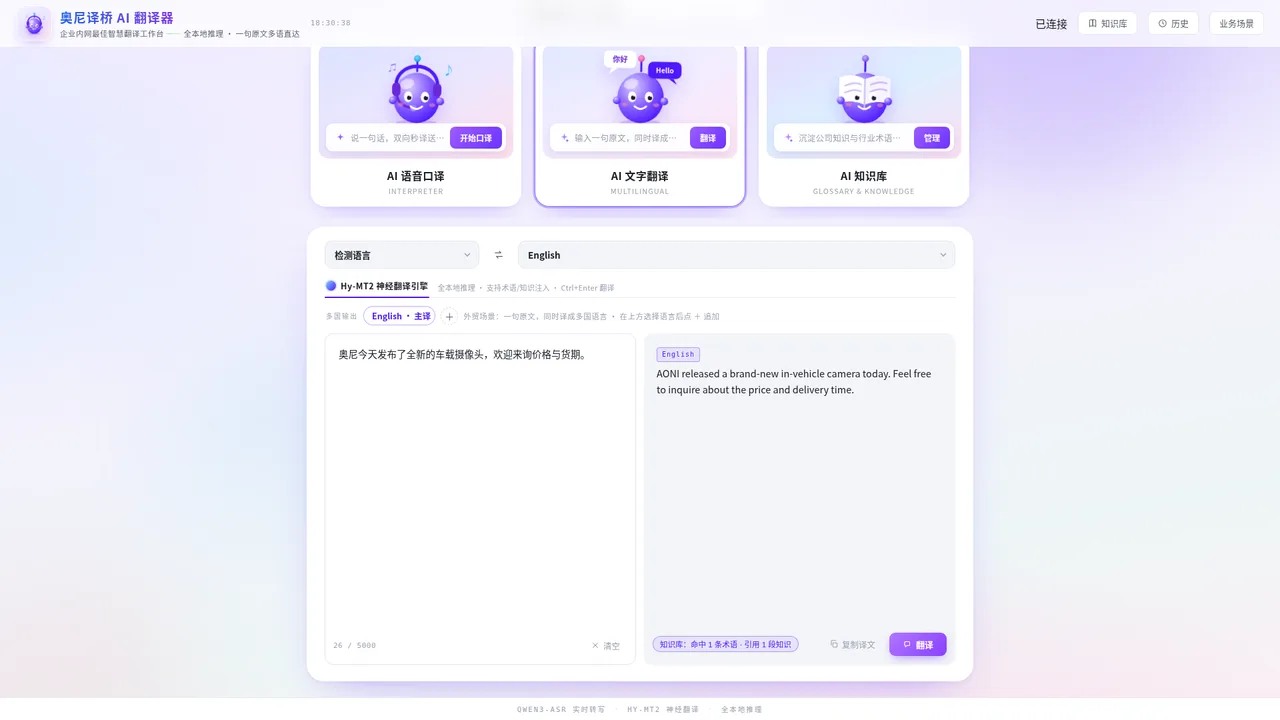
· 双人语音口译:双方各选语言、点对应麦克风,VAD 自动断句,原文+译文实时送达对面,支持 29 种语言与 22 种中文方言识别 · 文字翻译:一句原文同时译成多国语言(12+ 语言),流式输出 · 术语 / 知识库:公司术语与行业知识翻译时自动注入,译法统一,多设备共享同一份(服务端存储) · 业务场景:外贸物流内置场景(询盘报价 / 异常通报 / 订舱指令 / 提单补料 / 海关问答),含实体规则复检、歧义消歧与三档语气回信(强硬 / 中性 / 柔和) · 全本地推理:Qwen3-ASR-1.7B + Hy-MT2-7B 全程本地运行,数据不出内网 · 历史对话:全部翻译记录可查看、按文本导出、删除