
返回应用列表
锐音
数字人视频,语音合成,口型驱动,音色克隆
应用介绍
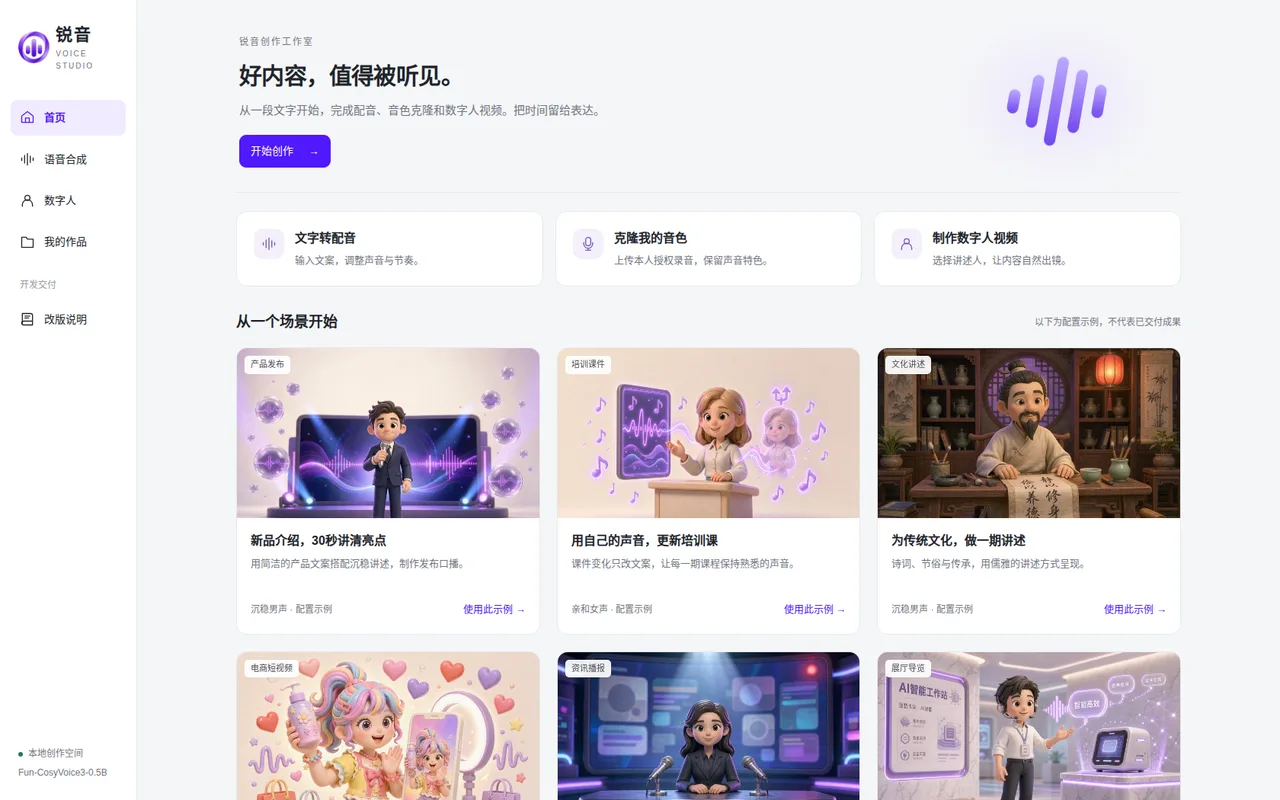
锐音是面向内容创作者与企业的 AI 数字人视频&配音创作平台:输入文案,经 AI 助写优化后,用本机 CosyVoice 3.0 合成真人级语音、MuseTalk 驱动数字人口型,一键生成说得准、口型同步的数字人视频或配音音频;支持零样本音色克隆、形象选择、情感/语速/方言/多语言控制、作品管理与分享。本地离线部署(aarch64 原生镜像,NVIDIA Jetson/Thor 直接运行)。
部署方式
部署方式
本应用为 aarch64 原生镜像(NVIDIA Jetson/Thor 等 ARM64 平台直接部署运行,不支持 x86_64)。 架构为 2 个 Docker 服务:CosyVoice 3.0 TTS 主服务 + LiveTalking(MuseTalk 口型驱动)数字人;镜像已推送至火山云容器仓库。
硬件要求
- NVIDIA GPU(已在 NVIDIA Thor / AGX 统一内存架构实测)
- 显存:TTS ≥ 6GB;数字人视频(MuseTalk)需 GPU 推理
- 系统:Ubuntu 24.04(aarch64)
方式一:AI Agent OS 应用中心一键部署(推荐)
- 已按 AI Agent OS 模板打包(tts-v1.0.0.tar.gz,含 deploy.yml / manifest.yml),上传后直接从火山云仓库拉镜像部署;
- 平台自动分配访问端口,Web 工作台入口 http://:;可接入本地大模型(smart-router,AI 助写自动连接)。
方式二:Docker(镜像已推送,直接拉取)
docker pull aoni-docker-cn-guangzhou.cr.volces.com/public/app/tts:latest
docker pull aoni-docker-cn-guangzhou.cr.volces.com/public/app/tts-musetalk:latest
docker compose up -d
curl -s localhost:50000/healthz
- 前置:CosyVoice/pretrained_models/Fun-CosyVoice3-0.5B/ 下有完整模型(约 9.1GB)
- 访问 http://<本机IP>:50000 即得完整界面。
方式三:本地 Python(不带容器)
source venv_cosyvoice/bin/activate
python3 server.py --port 50000
端口说明
- 50000:锐音 Web 应用 + TTS API(对外访问)
- 8020 :LiveTalking MuseTalk 数字人(内部 WebRTC/wav2lip,host 网络)
使用说明
· **数字人视频:**输入文案即可生成说得准、口型同步的数字人视频;CosyVoice 合成真人级语音 + MuseTalk 驱动口型,真实渲染,非模板拼接。 · **配音音频:**一键把文案合成为自然、有情感的配音(支持情感/语速/风格标签、方言/多语言),可用于播报、有声内容。 · **音色克隆:**上传 3–10 秒参考音频(或浏览器录音)零样本克隆/新增音色,可选预设说话人(男女声、中英日韩)。 · **AI 助写:**接入大模型把粗略想法扩写成完整口播文案,自动回退确定性引擎,功能不缺失(模型 auto 自动挑选健康后端)。 · **数字人形象:**内置多种商务/讲师/主播形象,16:9 / 9:16 竖版横版切换,昵称与形象摘要实时联动。 · **作品管理:**生成作品自动记录(预览/导出/批量操作/删除),同需求作品折叠去重,草稿本地自动保存、刷新恢复。 · **分享链接:**成片一键生成 24 小时有效分享链接,交付客户与团队无需登录即可预览。 · **线下可部署:**本地离线运行,数据不出内网,适配政企/私有化场景。